Marin:开放实验室到底解决了什么问题
大部分开放模型,放出来的就是一份权重加一份技术报告。Marin 连实验记录都摊开给你看,失败的实验也不藏着,而且是边训练边公开。
我在自学大模型是怎么训出来的,从求导开始学。给自己定了个最终目标:把 Marin 正在跑的 535B 彻底搞懂,懂到能在纸上把它重新设计一遍。所以最近大把时间都泡在他们的报告、GitHub issue 和博客里。
Marin 是什么
Marin 是一个做基础模型的开放实验室,从斯坦福的基础模型研究中心(Center for Research on Foundation Models)孵化出来,2025 年 5 月和 Marin 8B 一起亮相。
他们每个实验都从一个 GitHub issue 开始,先在 issue 里写清楚要试什么、为什么试,相当于一份小型的“预注册”。代码提成 PR,谁都能 review。训练日志公开在 Weights & Biases 上。失败的实验也一直留着,跟成功的摆在一起。
这样一路下来,已经做出了 Marin 8B(2025 年 5 月)和 Marin 32B(2025 年底),还有一个 535B 的 MoE 模型,我写这篇的时候还在训。
问题一:说是“开放”,大多只放出了权重
他们官宣的时候就说得很直白:“现在有开放权重的模型(比如 Llama、DeepSeek、Gemma),有时大家会错把它们叫成开源模型,但训练这些模型用的代码和数据(也就是配方)并没有公开。”
有了权重,你能用这个模型,但学不会怎么自己做一个。已经有几个项目会把代码和数据跟最终模型一起放出来,比如 AI2 的 OLMo 和 EleutherAI 的 Pythia。Marin 更进一步,连过程本身都边做边公开,做过哪些决定、走过哪些死胡同,全在里面。
问题二:常规手段压不住的 loss spike
他们的 32B 复盘,是我读过最精彩的一篇训练踩坑记。大致经过是这样的:
- 前 70K 步训练看着都正常,就是 loss spike 比 8B 那次多得多。有人跟他们说,这次训练没救了。
- 他们先收紧了梯度裁剪。正常情况下 grad norm 在 0.2 左右,一旦猛地跳上去,紧接着往往就是一个 spike。
- 72K 步左右,又加了 update norm clipping:盯着优化器每一步的更新幅度,算出滑动均值和标准差,比均值高出两个标准差以上的,一律裁掉。
- 还加了一条规则,碰到坏的 step 直接跳过。
- 然后在 74K 到 80K 步之间,他们不小心让 update norm 过滤器一直关着,一关就是几千步。
- 到了 80K 步,spike 已经躲不掉了。他们试了一种叫“necromancy”(招魂术)的重启,离线把优化器状态重建一遍,撑了几千步,又复发了。换成 Muon 优化器跑的那一版,干脆发散了。
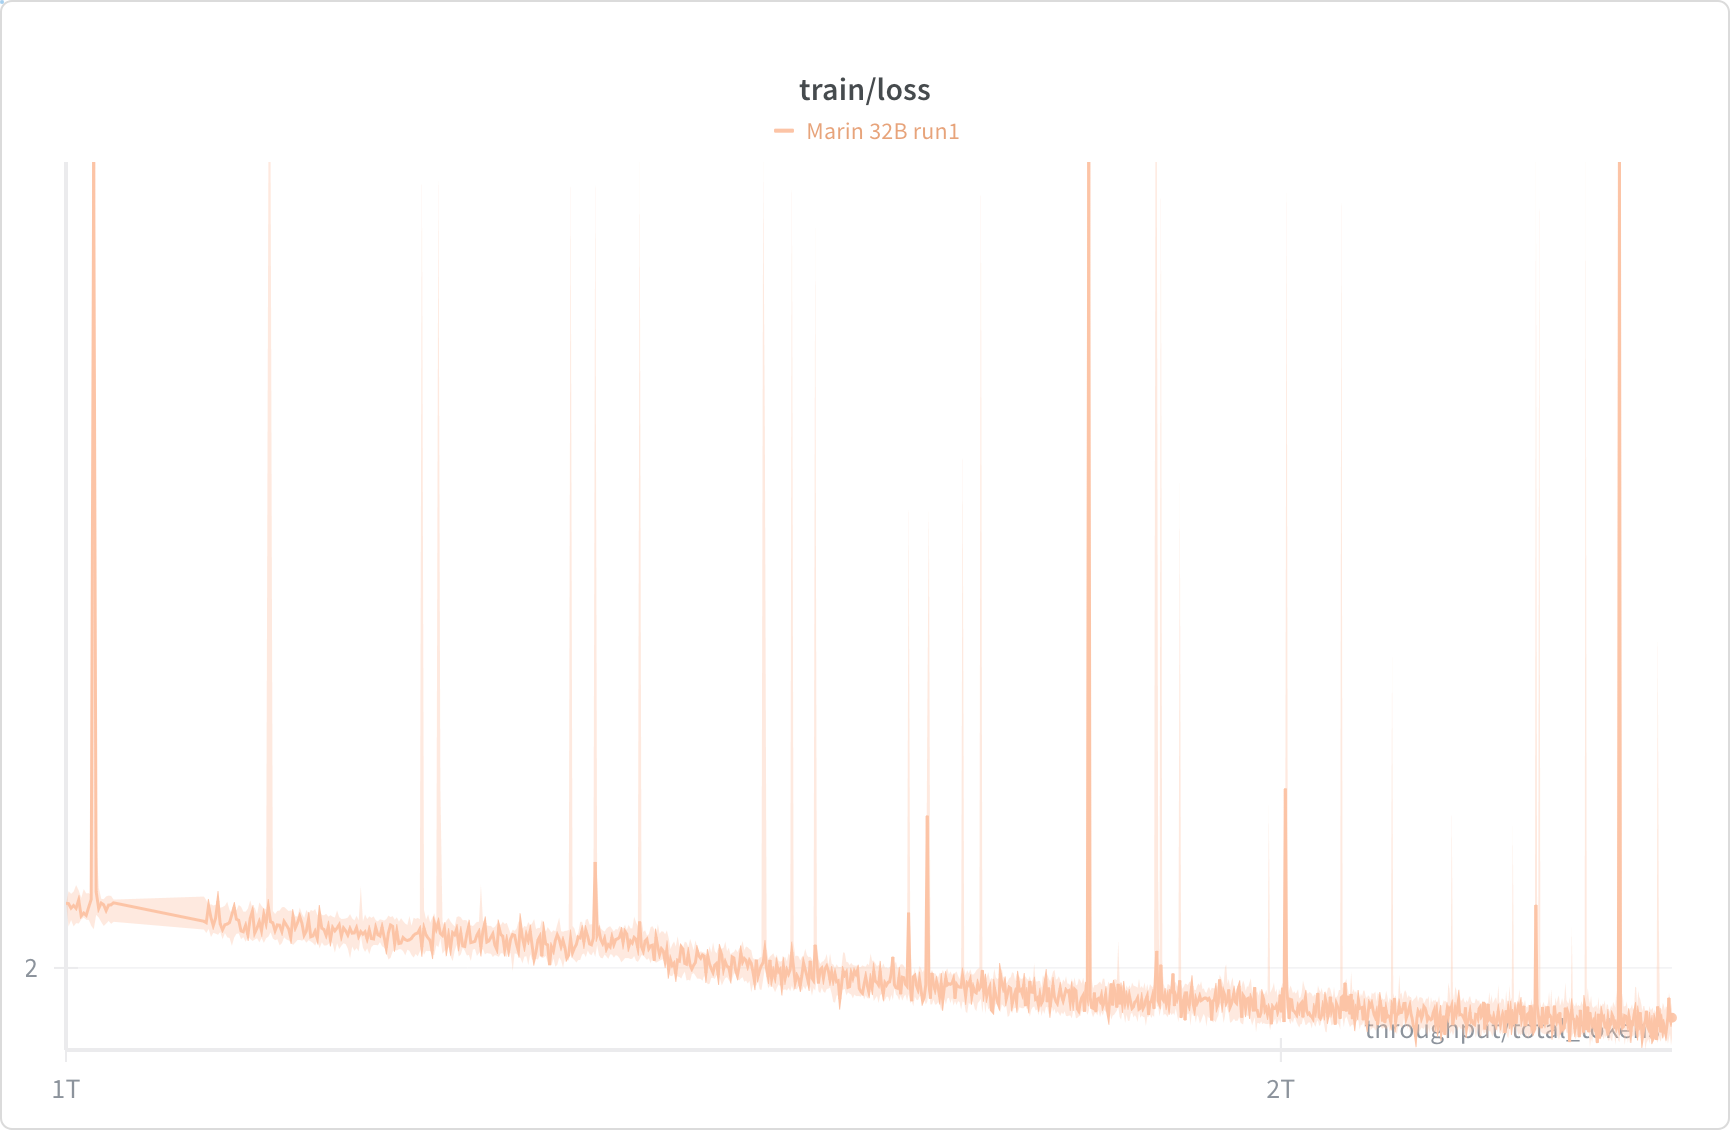
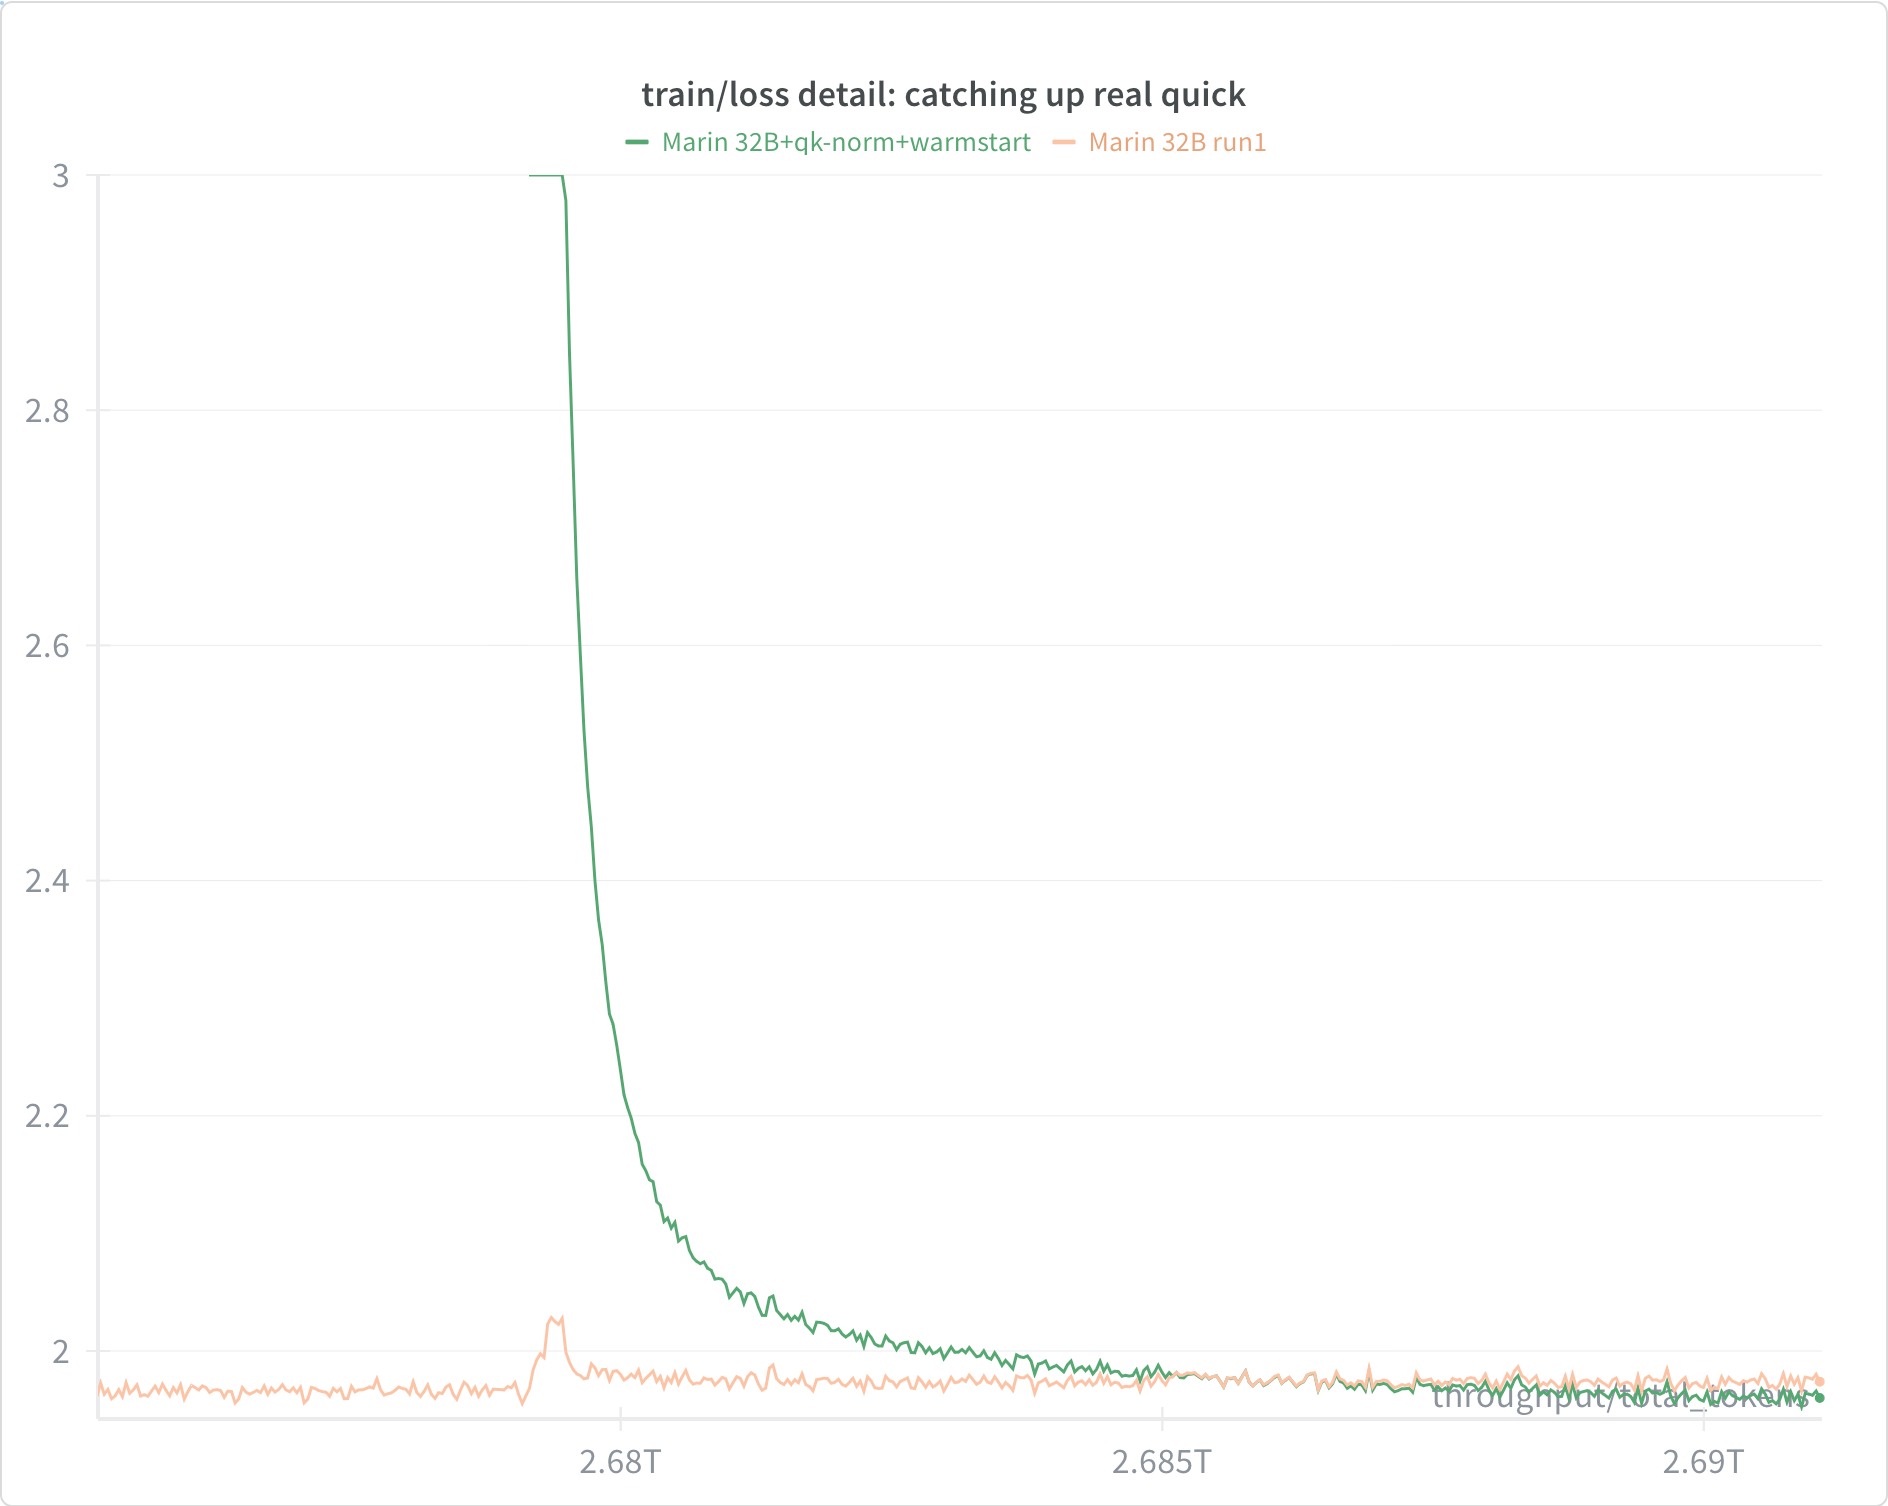
最后真正管用的是改架构。他们换成了 Qwen3 32B 的结构,这套结构在注意力层里多了 QK-norm。然后拿第 80K 步的 Llama 权重做热启动。切过去的时候 loss 涨了一下,大约 10B 个 token 就恢复了,之后 spike 再也没回来。
那为什么不一开始就用 QK-norm?他们的回答坦诚得可爱:“8B 的经验让我们有点飘了。”8B 没加 QK-norm 也训得好好的,更早试过的一次 70B 也一样。
他们自己对这件事的总结,我想抄下来贴在显示器上:“到了这个规模,光靠监控和干预,代替不了改架构。”
换成一般的技术报告,上面这些只会剩下一句:“我们使用了 QK-norm。”这份复盘让你看到,这一句话是花了多大代价换来的。
问题三:没人会写进报告的数据 bug
到了 cooldown 阶段,GSM8K 的测试集漏进了训练数据,源头是一个缓存的数据包。另外,数据顺序也出了问题:原来排顺序靠的是一个线性同余生成器做的置换,排得很差,于是换成了用 Feistel 结构做的 shuffle。
这两个 bug 都会让你最后报出来的数字变样,可这种 bug 几乎从来不会写进技术报告。
问题四:用小实验预测大规模训练
535B 这种训练只有一次机会,所以最好开跑之前就知道结果。Marin 专门为这个做了一套 scaling law 工具,叫 Delphi。第一版失败了,但失败得很有价值:它是拿小规模训练拟合的,预测 1e22 FLOPs 那次训练时偏了 2.5%,而 1e23 那次训练彻底发散了。
原因说起来都挺平常。一是算学习率的那套规则,碰到训练长、数据多、batch 又大的情况,给的学习率太高。二是 weight decay 在所有训练里都写死成 0.1,不会随训练长度或模型宽度调整。
所以他们换了一个不用调 weight decay 的优化器(AdamH),加了一项修正,训练越长学习率就压得越低,还重新调了参考模型。第二版只用 3e20 FLOPs 以内的训练来拟合,预测 1e21、1e22、1e23 三次训练,误差分别在 +0.5%、+0.2%、+0.2% 以内。
535B 开跑之前,他们先把预测的最终 loss 写了出来:在 Paloma 评测集上大约 2.04。这个数是拿一组由小到大的训练(也就是 ladder)推算出来的,这组训练加起来用了总算力的 1% 左右。等训练跑完,谁都可以来对答案。
问题五:学术实验室怎么训前沿规模的模型
现在在训的模型叫 Marin 535B-A23B,意思是总参数 535B,每个 token 激活其中大约 23B。从公开的规格里挑几个主要数字:
- 48 层,384 个路由专家,每个 token 选 8 个,另外还有 2 个共享专家,所有 token 都会经过
- 训练用 18T token,总计算量大约 2.7e24 FLOPs
- 硬件是 CoreWeave 上的 11 个 GB200 NVL72 机柜,钱来自黄仁勋夫妇基金会(Jen-Hsun and Lori Huang Foundation)的一笔资助。之前的模型用的是 Google TPU Research Cloud 提供的 TPU。
连并行方案为什么这么选,他们都专门写了篇文章。完整的训练状态每个参数要占 16 字节,加起来将近 8 TiB。要是用 FSDP 来切专家,每张 GPU 每一层要搬大约 20 GiB 的权重。换成专家并行,搬的是大约 6 GiB 的激活值。在他们的小规模 ladder 上估算,这样计算效率能提高 18% 到 35%。硬件利用率也从早期测试的 15%,涨到了正式训练时的 23% 左右。
你还能直接去问他们。这次训练的 GitHub issue 里,有人问为什么要先把 token 投影到一个更小的“latent”,再发给专家。一位 Marin 工程师拿数字回答了这个问题。光是 latent 投影本身,就能把通信成本减半。不给它加可学习的 norm,效果就差了 30%。把专家配置从“192 个里选 4 个”换成“384 个更小的专家里选 8 个”,效果好了 15%,但通信量也翻了一倍。用 latent 这招,正好能保住这 15% 的提升,通信和计算上都不用多付代价。
到 10 月 7 日,训练进度是 56%(18T token 跑了 10.1T),预计 11 月 14 日跑完。状态页上每一次中断都有记录。最近一次是 10 月 6 日,Kubernetes 把一个节点判成坏节点,删掉了它上面的训练任务,结果剩下的 175 个任务也跟着一起挂了。
我的收获
- 他们的 MoE 实验汇总里列了 80 个想法,16 个管用,32 个不管用。把这 32 个失败公开出来,别人就不用再为它们交一遍学费。
- 开跑前先把预测的 loss 写下来,“训得很顺利”就成了一句谁都能核对的话。
- 大部分苦活都不光鲜:loss spike、有问题的 shuffle、数据污染、挂掉的节点。选架构只是一个决定,要让训练一直跑下去,还得再做几百个。
- Marin 是我找到的最好的教材。他们的 issue 读起来就像实验记录本。想搞懂训练到底是怎么回事,先读 8B 和 32B 的复盘,再去翻综述论文。
封面:Joseph Wright of Derby 1771 年画的《炼金术士发现磷》(The Alchemist Discovering Phosphorus),截取局部,公有领域。国内圈子里,大家都管训模型叫“炼丹”。Marin 想做的,就是把炼丹变成化学。